AI-nyheder · Nye værktøjer og opdateringer · 16. september 2026 · Begynder
Google lancerer Gemini 3.8 Live med vision, stemme og 97 sprog
Google har udgivet Gemini 3.8 Live og 3.8 Live Extended Thinking, nye stemmemodeller der kan se, ræsonnere og løse opgaver i baggrunden, mens samtalen fortsætter uden afbrydelse. Modellerne understøtter 97 sprog og topper en central benchmark for stemme-til-stemme-kvalitet.
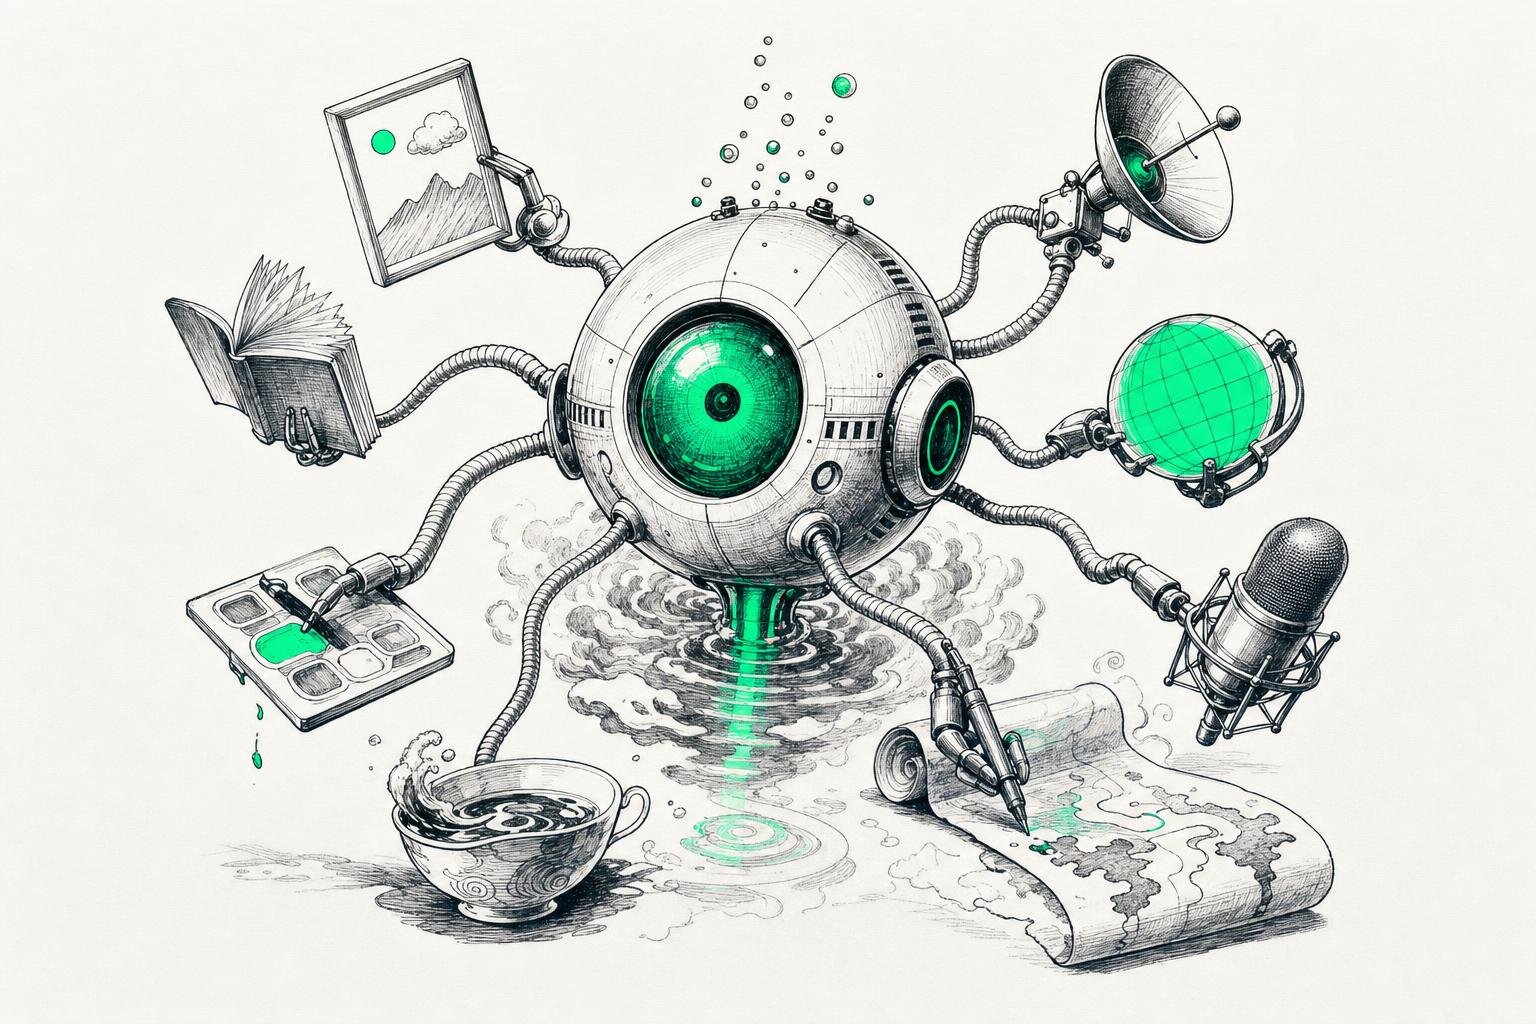
Google har udgivet to nye modeller i sin Gemini Live-serie: Gemini 3.8 Live og Gemini 3.8 Live Extended Thinking. Modellerne er bygget til realtids stemmesamtaler og kan ifølge Google håndtere afbrydelser, skifte sprog midt i en samtale og udføre opgaver i baggrunden, uden at samtalen går i stå.
En central nyhed er, at modellerne kan behandle levende billeder i nær realtid og bruge det som kontekst i samtalen. Google viser blandt andet eksempler, hvor Gemini 3.8 Live guider en medarbejder gennem onboarding ud fra det, den ser, og følger med visuelt, mens den spiller skak.
Modellerne understøtter automatisk 97 sprog og kan skifte mellem dem midt i en samtale. Samtidig kan de udføre værktøjskald og API-kald asynkront, mens de taler videre. Det betyder, at Gemini kan sige noget i stil med "lad mig lige tjekke det" og fortsætte samtalen, mens en opgave løses i baggrunden.
Gemini 3.8 Live Extended Thinking er den mest avancerede udgave og er lavet til dybere, flertrins-ræsonnement, mens den taler. Ifølge kilderne ligger den nummer et på Artificial Analysis' stemme-til-stemme-kvalitetsindeks med en score på 82,6, foran blandt andet GPT-Live-1 Astra. Den scorer også 68,6 procent på benchmarken τ-Voice og 35,1 procent på Sierras τ-Voice-banking-test for agentopgaver samt 97,7 procent på Big Bench Audio. Den almindelige Gemini 3.8 Live-model ligger nummer to i Speech Agent Arena, og på ServiceNows EVA-Bench, der tester voice-agenter på komplekse arbejdsgange, rykker modellerne ifølge Google grænsen for, hvor godt man kan kombinere præcision og naturlig samtale.
Modellerne er allerede tilgængelige for udviklere via Gemini API og Google AI Studio og for almindelige brugere via Gemini-appen, Google Workspace og Search. Til udviklere findes desuden integrationer via partnere som LiveKit, Pipecat, LangChain, Vercel, Agora og Fishjam, der håndterer den tekniske infrastruktur til mediestreaming.
Prisen på modellerne fremgår ikke entydigt af det tilgængelige materiale. Google selv oplyser 0,005 dollar pr. minut for lydinput og 0,018 dollar pr. minut for lydoutput, mens en anden kilde nævner 0,84 dollar i timen for standard Live-lydinput og 3,50 dollar i timen for Extended Thinking (High). Det fremgår ikke, om der er tale om forskellige opgørelsesmetoder.
Sammen med lanceringen nævnes også Gemini 3.5 Transcribe, en dedikeret tale-til-tekst-model, der blev udgivet sidste måned. Den understøtter over 85 sprog og har en gennemsnitlig fejlrate (WER) på 4,0 procent i streaming og 2,6 procent uden streaming. Modellen kan bruges til blandt andet live-undertekstning og callcenter-agenter, og via Interactions API kan den transskribere lydfiler på op til en time med tidsstempler og talergenkendelse.
For den almindelige AI-bruger betyder lanceringen, at stemmestyrede assistenter i praksis bliver mere anvendelige til egentligt arbejde og ikke kun korte spørgsmål og svar. At modellen kan se med, forstå flere sprog automatisk og arbejde videre med en opgave, mens man taler om noget andet, peger mod stemmeassistenter, der fungerer som en reel samarbejdspartner frem for blot en kommandolinje med mikrofon.
Kilder
Mere om emnet
Få ugens AI-nyheder i indbakken
Vælg selv niveau, emner og længde. Én mail om ugen, afmeld når som helst.
Tilmeld dig Promptly Nyhedsbrev